本页目录
知识服务
知识服务统一维护租户内全部知识库的模型、文档处理和检索参数;各知识库单独维护基本信息、成员、内容与索引绑定。
配置层次
| 位置 | 维护对象 | 影响 |
|---|---|---|
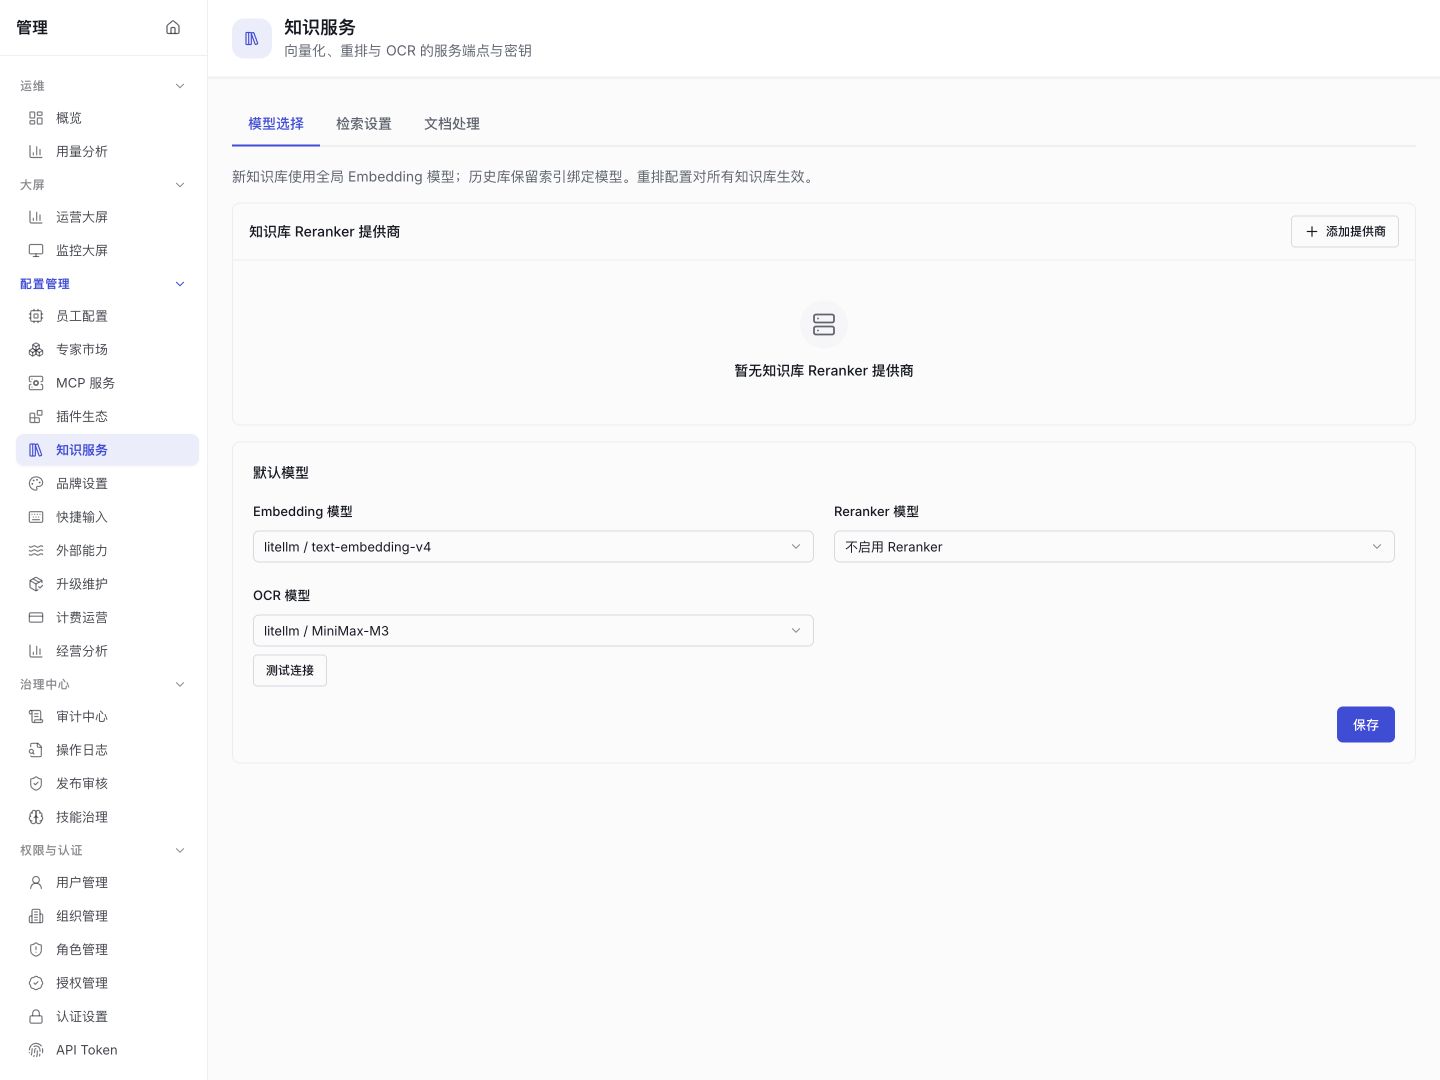
| 模型选择 | Embedding、Reranker及OCR模型,Reranker提供商 | 新库使用全局Embedding;历史库保留索引绑定;重排配置对全部库生效。 |
| 检索设置 | 全文/向量权重、召回数量、置信度阈值、重排 | 全部知识库统一使用。 |
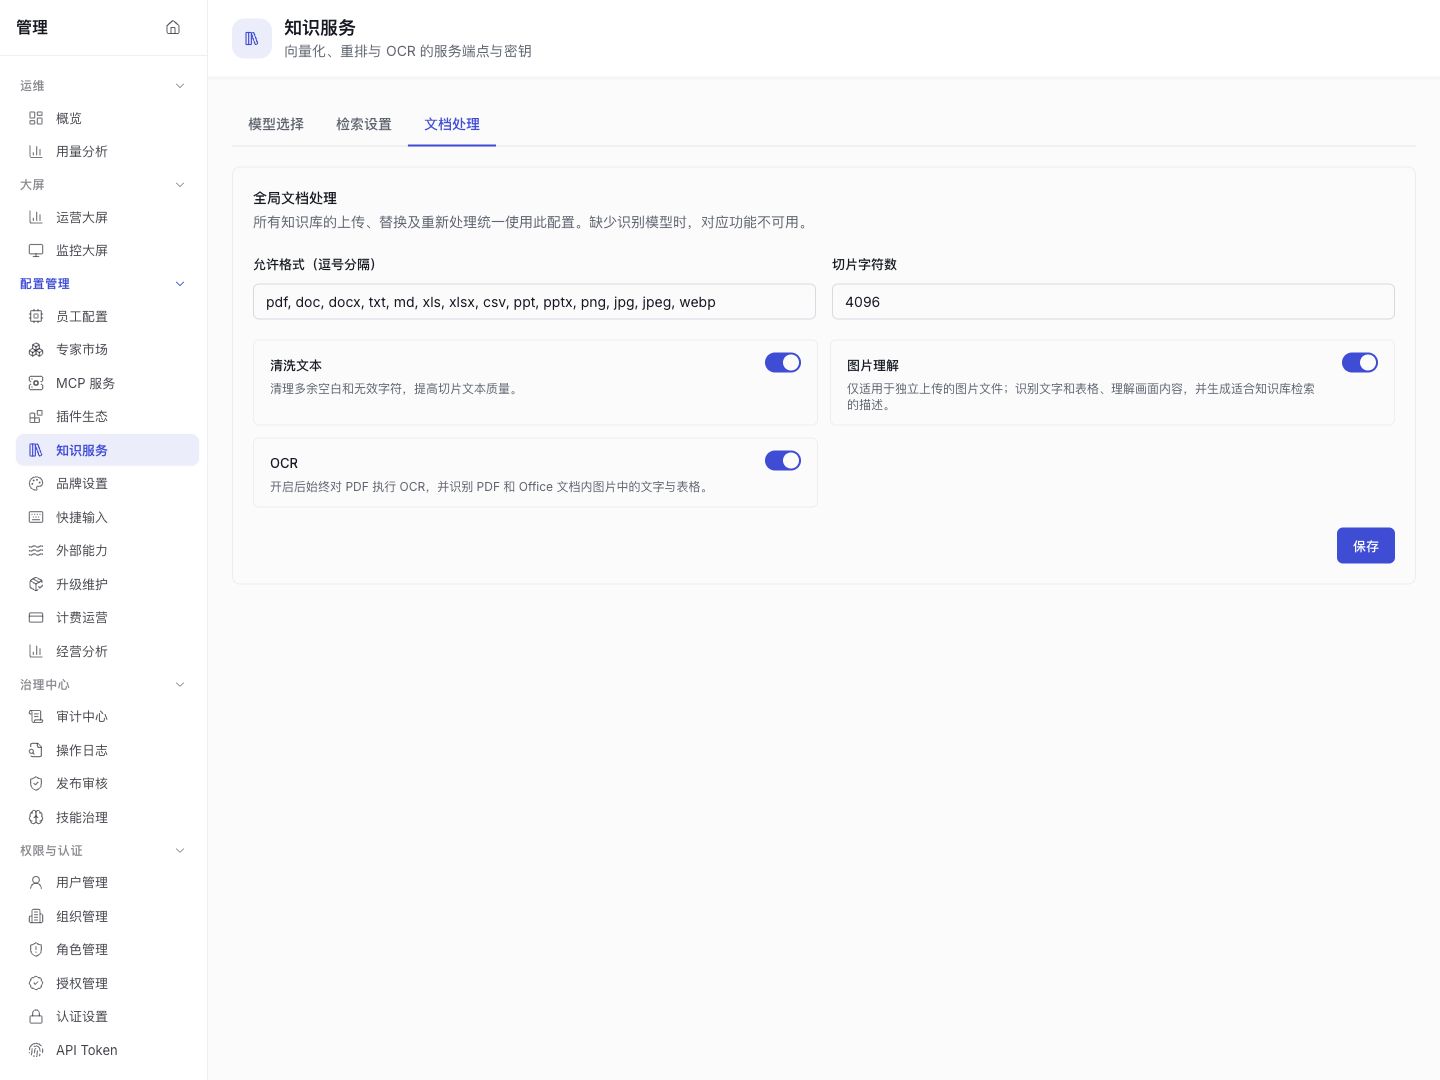
| 文档处理 | 允许格式、切片字符数、清洗、图片理解、OCR | 全部库的上传、替换及重新处理统一使用。 |
| 知识库 | 名称、说明、成员、文件及索引状态 | 目标库及其访问和处理状态,不覆盖全局检索/处理参数。 |
| 单次检索 | 查询、范围及测试参数 | 当前查询,不等于永久修改全局设置。 |
模型引用
| 模型 | 作用 |
|---|---|
| Embedding | 支持向量化。 |
| Reranker | 调整候选顺序。 |
| OCR | 支撑相应内容识别。 |
模型兼容性取决于提供商、权重、版本、维度及归一化方式,不能只按模型名称判断。
创建知识库前,管理员需在“模型选择”保存全局 Embedding 模型;未配置时不能创建知识库。新知识库使用该模型,历史库保留索引绑定模型。
全局默认模型变更不会迁移历史库。Reranker 配置对全部知识库生效,启用重排需要模型与连接可用。
- 管理员不应将提供商密钥写入库说明、上传文件、截图或工单。
- 系统在保存时验证 Embedding 模型。
- “模型选择”中的“测试连接”用于 OCR 模型;未选择 OCR 模型时,该按钮不可用。
文档处理选项
| 选项 | 作用与范围 |
|---|---|
| 允许格式 | 按逗号分隔的扩展名维护。 |
| 切片字符数 | 影响分段规模。 |
| 清洗文本 | 清理多余空白和无效字符。 |
| 图片理解 | 仅适用于独立上传图片,识别文字表格、理解画面并输出适合检索的描述。 |
| OCR | 开启后始终对 PDF 执行 OCR,同时识别 PDF 和 Office 文档内图片中的文字与表格。 |
缺少识别模型时,对应功能不可用。配置变更只约束相应后续处理,不代表旧文件已经重新处理。
检索设置
| 参数 | 作用 | 取值 |
|---|---|---|
| 全文权重 | 偏向字面命中。 | 0–1。 |
| 向量权重 | 偏向语义相关。 | 0–1。 |
| 召回数量 | 控制候选规模。 | 1–100 整数。 |
| 置信度阈值 | 过滤弱相关项。 | 0–1。 |
| 重排 | 对候选二次排序。 | 按页面配置。 |
检索设置统一作用于全部知识库。检索测试只能选择当前身份有权访问且已加载的知识库。
测试窗口的初始检索配置来自已保存的全局设置。测试中的单次调整不会保存到全局设置;后台尚未保存的修改也不会进入测试初始值。
索引状态
索引状态包括就绪、需要重建、重建中和失败。历史索引与其 Embedding 模型绑定;更改全局模型不会自动更换绑定。
涉及历史库模型变更时,管理员先通过技术支持确认该版本支持的处理方式和兼容要求。
索引重建占用处理资源。实际耗时取决于资料量与服务状态。
权限与治理
后台配置仅向具备相应资格的管理员开放。管理浏览支持知识库治理与成员维护,不授予正文读取权限。
来源应用管理的知识库和资料遵循来源侧规则。历史独立权限继续按对应限制判定。
诊断信息
知识任务的诊断代码、阶段、尝试次数、警告和最终结果帮助定位服务或文件问题。等待容量、等待适配服务、格式转换、解析和建索引属于不同阶段。
配置恢复后,原失败任务的结果与索引状态用于判断是否需要重新处理文件。
操作见知识服务。